Narzędzia do śledzenia Linuxa: perf, ftrace, eBPF, LTTng
TL;DR — decyzja w 30 sekund
| Narzędzie | Dla kogo | Dlaczego nie |
|---|---|---|
| perf | Profilowanie CPU, hotspots, statystyki sprzętowe, call graph. Działa z każdym kernelem od 2.6. | Brak programowalności — nie da się zapytać o dowolne zdarzenie bez znajomości listy tracepoints. |
| ftrace | Śledzenie funkcji kernela bez dodatkowych narzędzi, latencje, tracepoints. Wbudowany, zero zależności. | Wymaga znajomości ścieżek w /sys/kernel/tracing. Output tekstowy, trudny do automatycznego przetwarzania. |
| eBPF (bpftrace) | Dynamiczne śledzenie bez restartu, agregacja w kernelu, niestandardowe metryki, produkcja. | Wymaga kernela ≥ 4.1 (praktycznie ≥ 5.x dla pełnego zestawu). Programowanie w ograniczonym C — krzywa uczenia. |
| LTTng | Długie nagrania, post-mortem, real-time. Najniższy overhead w śledzeniu przestrzeni użytkownika. | Out-of-tree — wymaga DKMS na każdy update kernela. Na kernelu 7.0 moduły muszą zostać skompilowane osobno. |
Zasada: perf do statystyk i profilowania, ftrace do funkcji kernela, eBPF do niestandardowych metryk w produkcji, LTTng do długich nagrań i post-mortem. Każdy z nich jest kompletny w swoim zakresie.
Overhead per zdarzenie — benchmarki
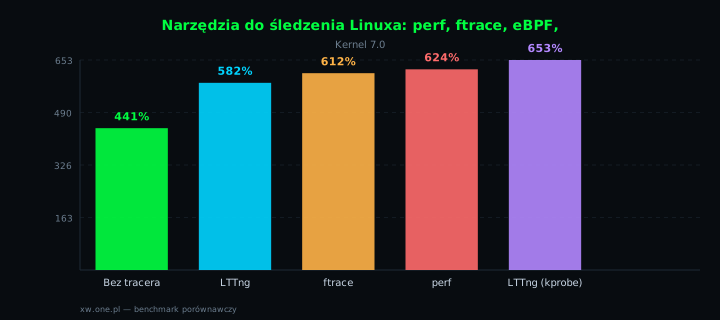
Dane z badania Polytechnique Montréal (Gebai, 2018, kernel 4.5, Intel i7, payload 32 bajty, steady state): latencja rejestracji jednego tracepointa w przestrzeni kernela. Wartości w nanosekundach, odsetek to overhead względem systemu bez tracera.
| Narzędzie | Średnia (ns) | Overhead | 90. percentyl (ns) |
|---|---|---|---|
| Bez tracera | 17 | — | 17 |
| LTTng | 92 | +441% | 89 |
| ftrace | 116 | +582% | 114 |
| perf | 121 | +612% | 118 |
| LTTng (kprobe) | 123 | +624% | 121 |
| eBPF-tracing | 128 | +653% | 124 |
| eBPF (pełny) | 140 | +724% | 126 |
Dla śledzenia syscalli (ioctl, payload 32 bajty) obraz jest inny — tutaj ftrace i LTTng są bliżej siebie, a perf wyraźnie droższy: ftrace 311 ns, LTTng 341 ns, perf 600 ns. Różnica wynika z faktu, że perf przy syscallach wykonuje pełną ścieżkę przez perf_events z kontekstowym przełączaniem.
W praktyce: eBPF kprobe kosztuje 20–80 ns per wywołanie na nowoczesnym x86-64. To daje 16–33 mln zdarzeń na sekundę na CPU, zanim rdzeń będzie nasycony. Dla porównania, strace (ptrace) spowalnia cel o ponad 100×.
Zakres zastosowań
perf — statystyki i profilowanie
perf to narzędzie do odpowiedzi na pytanie: gdzie CPU spędza czas? perf stat pokazuje liczniki sprzętowe (cykle, instrukcje, brak predykcji gałęzi, cache misses). perf record + perf report generuje call graph — widoczne jest dokładnie, które funkcje jedzą czas. perf top działa jak htop dla funkcji. W kernelu 7.0 dodano perf sched stats — nowy podsystem do pomiaru statystyk schedulera przez /proc/schedstat.
- perf stat -e cycles,instructions,branch-misses -- make — podstawowe statystyki kompilacji
- perf record -F 99 -ag -- sleep 5; perf report — profilowanie systemowe 5 sekund
- perf top — interaktywny widok hot funkcji w czasie rzeczywistym
- perf sched record -- sleep 1; perf sched latency — opóźnienia schedulera
ftrace — funkcje kernela
ftrace jest w kernelu od 2008 roku. Kontrolowany przez pliki w /sys/kernel/tracing. Dostępne tracery: function (wszystkie funkcje kernela), function_graph (graf wywołań z czasem), irqsoff (sekcje z wyłączonymi przerwami), preemptoff, wakeup (max latencja od wybudzenia do schedulacji), hwlat (latencje sprzętowe). Wymaga debugfs zamontowany. Najprostszy setup: echo function > current_tracer, echo 1 > tracing_on, cat trace_pipe.
eBPF — programowalne śledzenie
eBPF (extended Berkeley Packet Filter) pozwala dołączyć małe programy do zdarzeń kernela w runtime: kprobes, tracepoints, uprobes, XDP hooks, cgroup. Programy są weryfikowane przez verifier (nie mogą skruszyć kernela), JIT-kompilowane do natywnego kodu. bpftrace to frontend — jeden-liner zamiast pełnego programu C. Przykład: sudo bpftrace -e 'kprobe:vfs_read { printf("%s\n", comm); }' — wyświetla nazwę procesu przy każdym odczycie z pliku.
LTTng — długie nagrania i post-mortem
LTTng (Linux Trace Toolkit next generation) pisze binarne dane do ring buffera w pamięci. Daemon lttng-consumerd leniwie spłukuje je na dysk. Aplikacja nigdy nie czeka na I/O. Wersja 2.14 (2025) wprowadziła --buffer-allocation=per-channel — wspólny bufor dla wszystkich CPU zamiast per-CPU. Na 384-rdzeniowym serwerze AMD EPYC footprint spada z kilku gigabajtów do kilku megabajtów. LTTng jest out-of-tree na kernelu 7.0 — wymaga DKMS.
Wybór w zależności od scenariusza
| Scenariusz | Narzędzie | Dlaczego |
|---|---|---|
| Aplikacja wolna, gdzie jest bottleneck CPU? | perf record + perf report | Call graph, hot funkcje, cache misses — pełen obraz w 5 minut. |
| Latencja w kernelu, np. opóźnienie od wybudzenia do schedulacji? | ftrace (wakeup, irqsoff) | Wbudowany tracery do konkretnych typów latencji, zero konfiguracji. |
| Ile razy wywołano syscall X w ostatniej godzinie? | eBPF / bpftrace | Agregacja w kernelu — licznik rośnie, output minimalny, overhead ~30–60 ns. |
| Crash 3 dni temu, trzeba odtworzyć co się stało? | LTTng (flight recorder) | Ring buffer z trybem nadpisywania — ostatnie 60 sekund jest na dysku. |
| Produkcja, nie można restartować, trzeba niestandardową metrykę | eBPF | Dołączenie w runtime, verifier gwarantuje bezpieczeństwo, JIT daje niski overhead. |
| Szybki przegląd statystyk bez instalacji czegokolwiek | perf stat | Wbudowany w kernel, działa od razu, zero konfiguracji. |
Kernel 7.0 — co się zmieniło
W kernelu 7.0 podsystem perf zyskał obsługę liczników wydajności AMD Zen 6 (Family 1Ah, Model 50h–57h) — nowe zdarzenia dla predykcji gałęzi, aktywności cache L1/L2, TLB i uncore. Dodano perf sched stats — nowy workflow record/report/diff oparty na licznikach schedstat z /proc/schedstat. To pierwsze w drzewie perf narzędzie do bezpośredniej analizy statystyk schedulera bez ręcznego parsowania tracepoints.
Ważna uwaga: w 7.0-rc1 zlikwidowano tryb PREEMPT_NONE dla większości architektur — scheduler domyślnie przejmuje zadania w trybie PREEMPT_LAZY. Dla PostgreSQL na AWS Graviton4 (96 vCPU, 1024 klientów) throughput spadł o 48% (50 752 vs 98 566 ops/sec). Przyczyna: 55% czasu CPU spędzane w spinlocku s_lock() przy każdym przejęciu. Przygotuj: przed migracją na 7.0 z benchmarkowaniem bazy danych na celowym kernelu.
Na kernelu 7.0 perf jest pierwszym wyborem przy każdym nowym profilowaniu — obsługa Zen 6 i sched stats robi go kompletnym. ftrace pozostaje najprostszy do latencji. eBPF nie zmienia się znacząco. LTTng wymaga rekompilacji modułów przez DKMS przy każdym update.